Латентная диффузия: Миниатюрный чертеж
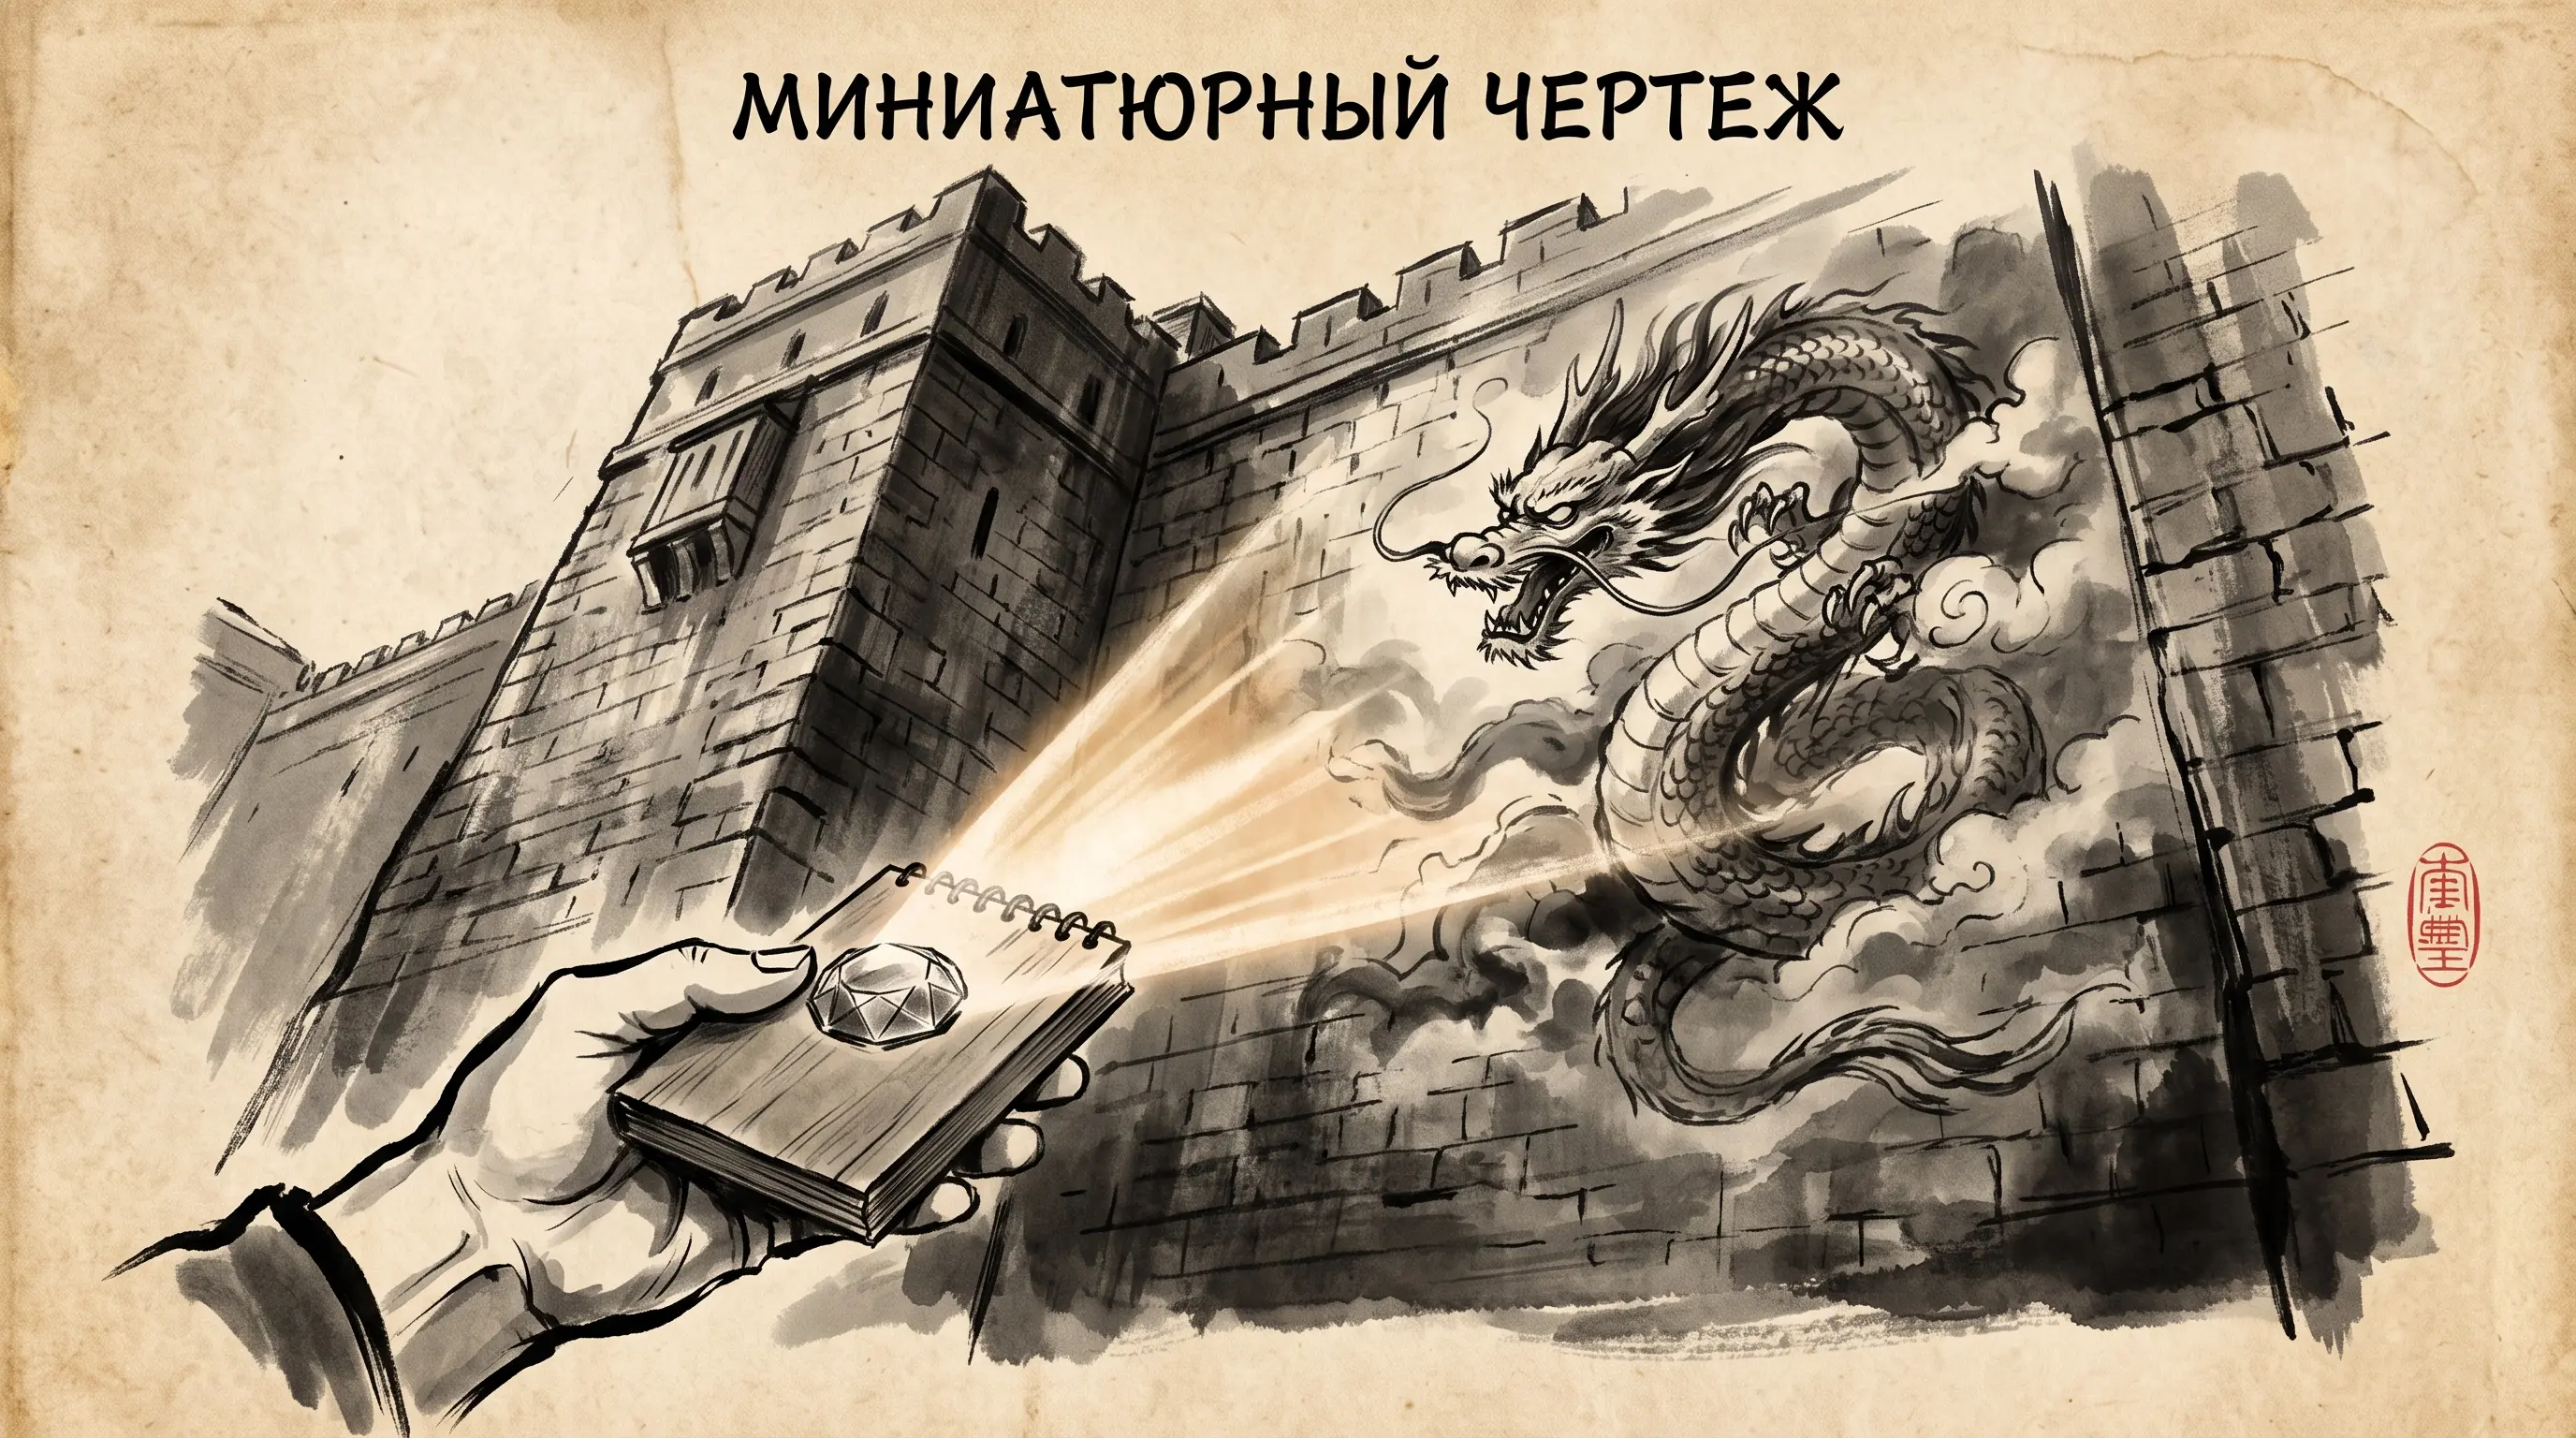
Художнику поручили расписать гигантскую стену замка шириной в пятнадцать метров. Если бы он пытался выполнять свой пошаговый процесс диффузии туши на каждом квадратном сантиметре этой огромной каменной стены, на это ушли бы десятилетия и целая армия помощников.
Вместо этого он достает из складок кимоно миниатюрный деревянный блокнот размером с ладонь.
На этом крошечном блокноте он творит свою магию диффузии: капает тушь, извлекает ее обратно и быстро вылепливает композицию — где встанет гора, куда повернет река, где полетит дракон. За считанные секунды он схватывает саму суть всей картины в миниатюре.
Когда миниатюрный чертеж готов, он накладывает на блокнот специальную хрустальную линзу. Кристалл проецирует и увеличивает миниатюрный набросок прямо на огромную стену замка, разворачивая каждую деталь и мгновенно заполняя текстуры с кристальной, детализированной четкостью.
Он не выполнял сложную мыслительную работу на огромной стене. Он сделал ее в миниатюре, где всё происходит молниеносно.
Реальность
Изображения высокого разрешения состоят из миллионов отдельных пикселей. Выполнение от 50 до 100 итераций шумоподавления напрямую на сырых пикселях требует чудовищных вычислительных мощностей и огромного объема памяти. Именно поэтому ранние пиксельные диффузионные модели работали мучительно медленно.
«Латентная диффузия» (Latent Diffusion — прорыв, стоящий за Stable Diffusion) решила эту проблему.
Вместо прямой работы с пикселями система использует автоэнкодер (VAE). Кодировщик (Encoder) сжимает гигантское изображение в компактное «скрытое пространство» (как тот карманный блокнот), делая его в 8–64 раза меньше, но сохраняя весь смысловой контекст. Затем диффузионная модель выполняет свою пошаговую магию исключительно внутри этого компактного пространства.
После завершения очистки от шума декодировщик (Decoder) разворачивает скрытое представление обратно в миллионы четких пикселей (подобно увеличивающему кристаллу).
Почему это важно
Именно латентная диффузия сделала современный генеративный ИИ доступным на практике. Разделив «творческое мышление» (которое быстро происходит в скрытом пространстве) и «отрисовку пикселей» (которая выполняется за один финальный шаг декодирования), генерация изображений стала достаточно быстрой, чтобы работать на обычных видеокартах и ноутбуках, а не только на гигантских суперкомпьютерах.
Главная мысль
Решайте сложную задачу в минимально возможном масштабе, прежде чем проецировать ее на реальный мир.
Специалисты по ИИ называют это: Модели латентной диффузии (Latent Diffusion Models, LDM) / Перцептивное сжатие
Вместо работы в многомерном пространстве пикселей x ∈ R^(H×W×3) энкодер E сжимает изображение в низкоразмерное скрытое представление z = E(x). Процессы диффузии и шумоподавления происходят полностью внутри пространства z. После завершения очистки декодер D восстанавливает финальное изображение x' = D(z_0), кардинально снижая вычислительную сложность при сохранении высокой детализации.
💬 Набрасывали ли вы когда-нибудь сложный план на салфетке или стикере, прежде чем переносить его на чистовик?
Часть 13 из 14 | #GenerativeModelsForHumans
#ai_edu На основе лекций Стэнфорда и индустрии